
콘텐츠 무단 수집, robots.txt 의 한계와 크롤링 대응 6가지
콘텐츠 무단 수집은 robots.txt 만으로 막을 수 없어 서버 제한과 권리 표시, 신고를 함께 써야 합니다. 이 글에서는 robots.txt 가 할 수 있는 일과 없는 일, 수집 봇을 줄이는 서버 쪽 조치, 복제가 확인됐을 때의 대응 순서를 정리했습니다.
콘텐츠 무단 수집이란 무엇인가
무단 수집은 프로그램이 홈페이지의 글, 사진, 가격표, 연락처 같은 정보를 자동으로 가져가는 것을 말합니다. 이를 흔히 크롤링이나 스크래핑이라고 부릅니다. 검색엔진의 수집처럼 운영자가 반기는 경우도 있지만, 허락 없이 가져간 글로 다른 사이트를 채우거나 회원 정보·연락처를 모아 스팸에 쓰는 경우는 피해가 됩니다.
수집 자체를 완전히 막을 방법은 없습니다. 브라우저로 볼 수 있는 내용은 프로그램으로도 읽을 수 있기 때문입니다. 그래서 목표는 수집을 어렵게 만들고, 가져간 흔적을 찾고, 복제가 드러났을 때 빠르게 내리게 하는 것으로 잡는 것이 현실적입니다.
무단 수집으로 생기는 피해
- 우리 글이 다른 사이트에 먼저 색인되어 검색 노출이 밀린다.
- 공개한 이메일·전화번호가 모여 스팸과 사칭에 쓰인다.
- 짧은 시간에 몰리는 수집 요청으로 사이트가 느려진다.
- 가격·상품 정보가 경쟁 사이트로 그대로 옮겨진다.
robots.txt 의 역할과 한계
robots.txt 는 사이트 맨 위 폴더에 두는 안내문으로, 검색 로봇에게 어느 주소를 수집해도 되는지 알려 줍니다. 기본 작성법은 robots.txt 작성 글에서 다룹니다. 여기서 알아 둘 것은 이 파일이 강제력이 없다는 점입니다.
Google 검색 센터는 robots.txt 의 지시가 크롤러의 동작을 강제로 제어할 수 없고, 웹페이지가 검색에 표시되지 않게 하는 수단도 아니라고 설명합니다. 다른 사이트에서 링크된 주소는 robots.txt 로 막아도 색인될 수 있다는 점도 함께 안내합니다. 원문은 Google 검색 센터의 robots.txt 소개에서 볼 수 있습니다.
즉 robots.txt 는 지시를 따르는 착한 로봇에게만 통합니다. 무단 수집을 하는 프로그램은 대부분 이 파일을 무시합니다. 오히려 막아 둔 주소 목록이 누구에게나 공개되므로, 숨기고 싶은 관리자 주소나 자료 폴더를 robots.txt 에 적는 것은 위치를 알려 주는 셈이 됩니다.
콘텐츠 무단 수집을 줄이는 대응 수단 비교
아래 표는 운영자가 쓸 수 있는 대응 수단을 막는 대상과 한계로 나누어 비교한 것입니다.
| 수단 | 효과가 있는 대상 | 한계 |
|---|---|---|
| robots.txt | 지시를 따르는 검색·수집 로봇 | 강제력이 없고 목록이 공개됨 |
| 요청 속도 제한 | 짧은 시간에 몰아서 가져가는 프로그램 | 천천히 가져가면 걸러지지 않음 |
| 로그인 뒤 공개 | 회원 전용 자료·연락처 | 검색 노출이 사라지고 이용 불편이 생김 |
| 연락처 노출 줄이기 | 이메일·전화번호 수집 | 문의 경로를 따로 마련해야 함 |
| 저작권 표시와 이용 안내 | 복제한 쪽에 권리를 알릴 근거 | 기술적으로 막지는 못함 |
| 삭제 요청과 신고 | 이미 복제된 페이지 | 시간이 걸리고 해외 사이트는 어려움 |
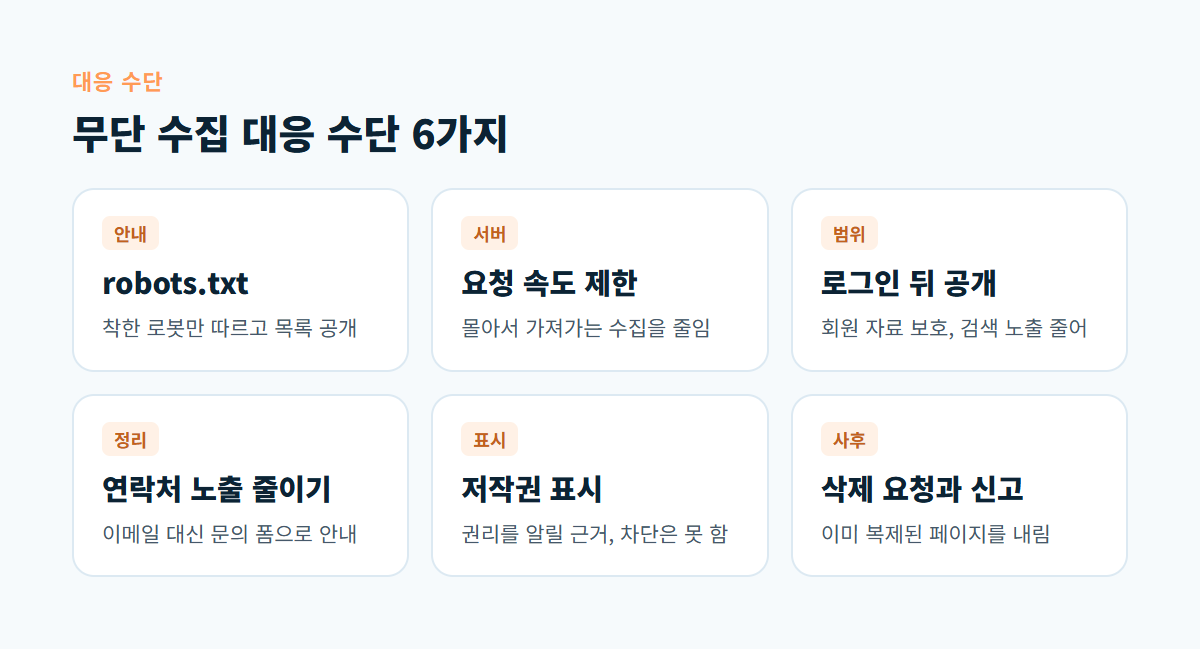
그림과 표처럼 수단마다 막는 대상이 다르므로 하나만 쓰기보다 겹쳐 쓰는 편이 낫습니다. 공개해야 하는 글은 속도 제한과 권리 표시로, 공개할 필요가 없는 자료는 로그인 뒤로 옮기는 식으로 나눕니다.
무단 수집과 복제에 대응하는 6단계
수집이 의심되거나 복제된 페이지를 발견했다면 아래 순서로 진행합니다. 앞의 세 단계는 예방, 뒤의 세 단계는 대응입니다.
- 공개 범위 정리: 꼭 공개해야 하는 글과 회원·내부용 자료를 나누고, 이메일 주소는 문의 폼으로 바꿉니다.
- 수집 흔적 확인: 서버 접속 기록에서 한 IP가 페이지를 차례로 빠르게 훑는 패턴을 찾습니다. 판단 기준은 악성 봇 트래픽 글을 참고하세요.
- 서버 제한 적용: 그런 요청에 속도 제한을 걸고, 효과가 확인되면 차단합니다.
- 복제 페이지 기록: 베껴 간 주소, 화면 캡처, 발견 날짜, 우리 글의 작성일을 남겨 둡니다.
- 삭제 요청: 복제 사이트 운영자나 호스팅 업체, 검색엔진에 삭제를 요청합니다. 자세한 순서는 콘텐츠 복제 사이트 대응 글에서 다룹니다.
- 상담과 재점검: 요청이 받아들여지지 않으면 공공 상담 창구를 이용하고, 한 달 뒤 같은 복제가 다시 생기지 않았는지 확인합니다.
저작권 침해 대응에 관한 상담은 한국저작권보호원이 전화 1588-0190과 온라인 창구로 받고 있으며, 안내는 한국저작권보호원 저작권 보호 상담에서 확인할 수 있습니다. 법적 조치가 필요한지는 사안마다 다르므로 상담이나 법률 전문가의 확인을 받으세요.
수집 대응 전에 확인할 체크리스트
막는 데만 집중하면 검색 노출이나 고객 이용을 해칠 수 있습니다. 조치하기 전에 아래 항목을 확인합니다.
- 검색 로봇까지 막는 규칙이 아닌지 확인했다.
- robots.txt 에 숨겨야 할 주소를 적지 않았다.
- 페이지 아래에 저작권 표시와 이용 안내가 있다.
- 공개 페이지에 이메일 주소를 그대로 적지 않았다.
- 우리 글의 작성일과 원본 파일을 보관하고 있다.
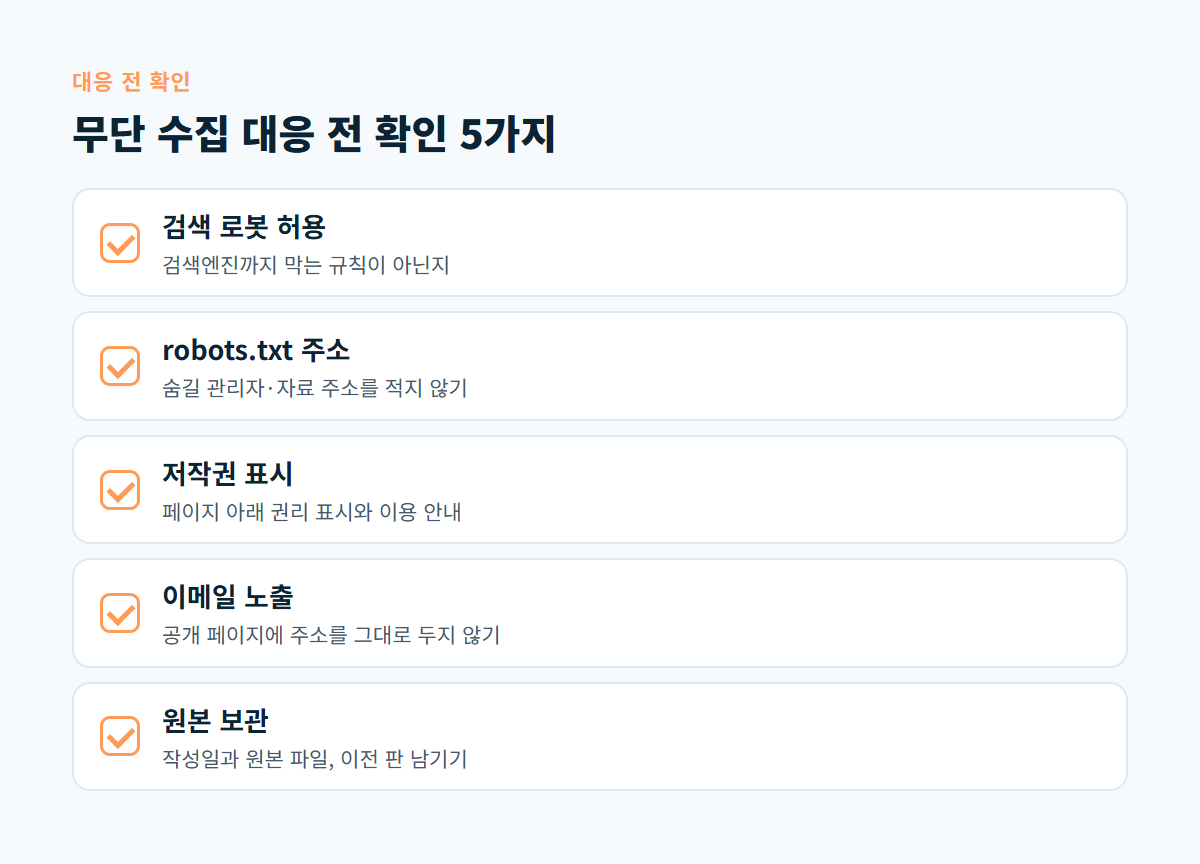
마지막 항목인 원본 보관은 나중에 복제 페이지보다 우리 글이 먼저였다는 것을 보여 주는 근거가 됩니다. 글을 고칠 때도 이전 판을 지우지 말고 남겨 두세요.
디코랩이 돕는 방식
디코랩은 운영 중인 사이트의 수정과 점검을 맡습니다. 연락처 노출 정리, 회원 전용 자료 분리, 수집 흔적 확인처럼 사이트 쪽에서 할 수 있는 조치가 필요하면 유지보수 접수 게시판에 비밀글로 요청을 남길 수 있습니다.
자주 묻는 질문
robots.txt 에 모든 로봇을 막으면 수집이 멈추나요?
지시를 따르는 로봇만 멈춥니다. 검색엔진까지 수집을 멈춰 검색 노출이 줄 수 있고, 무단 수집 프로그램은 그대로 들어올 수 있습니다.
마우스 오른쪽 클릭을 막으면 도움이 되나요?
사람이 복사하는 것을 조금 번거롭게 할 뿐, 프로그램 수집은 막지 못합니다. 이용 불편만 생길 수 있어 권하지 않습니다.
검색엔진에 우리 글이 원본이라고 알릴 수 있나요?
글을 먼저 올리고 사이트맵으로 빨리 색인되게 하는 것이 기본입니다. 복제 페이지가 검색에 나오면 검색엔진의 저작권 삭제 요청 절차를 이용할 수 있습니다.
가격 정보를 경쟁사가 가져가는 것도 막을 수 있나요?
공개한 정보는 완전히 막기 어렵습니다. 요청 속도 제한으로 대량 수집을 줄이고, 꼭 필요한 경우에는 상담 뒤 견적으로 안내하는 방식도 고려할 수 있습니다.
우리 사이트의 공개 범위와 수집 대응을 함께 점검하고 싶다면 디코랩 프로젝트 문의로 사이트 주소를 보내 주세요.
댓글0
댓글 작성 권한이 없습니다